Ollama
公司的资料不方便往云端贴,又不想到处开会员;或者只是不想为每句话都付 token 钱。Ollama 解决的就是这件事:把开源模型下到你自己的电脑上跑,命令行敲一句就能开始对话,模型下完断网也照用。
Ollama 能在本地跑哪些模型:一行命令装好、断网也能用
- 一行命令装好:macOS 和 Linux 用官网的 install.sh,Windows 用安装包或 install.ps1,装完自带命令行和桌面应用
- 本地跑开源模型:Qwen、DeepSeek、Gemma、gpt-oss 这些主流开源模型在模型库里都能一条命令拉下来
- 完全离线:模型下载完就不再联网,对话内容不出本机;名字带 :cloud 的是云端模型,那个要钱
- 本地 API:默认在 11434 端口起一个服务,带 OpenAI 兼容的 /v1 接口,自己的脚本和编辑器插件都能接
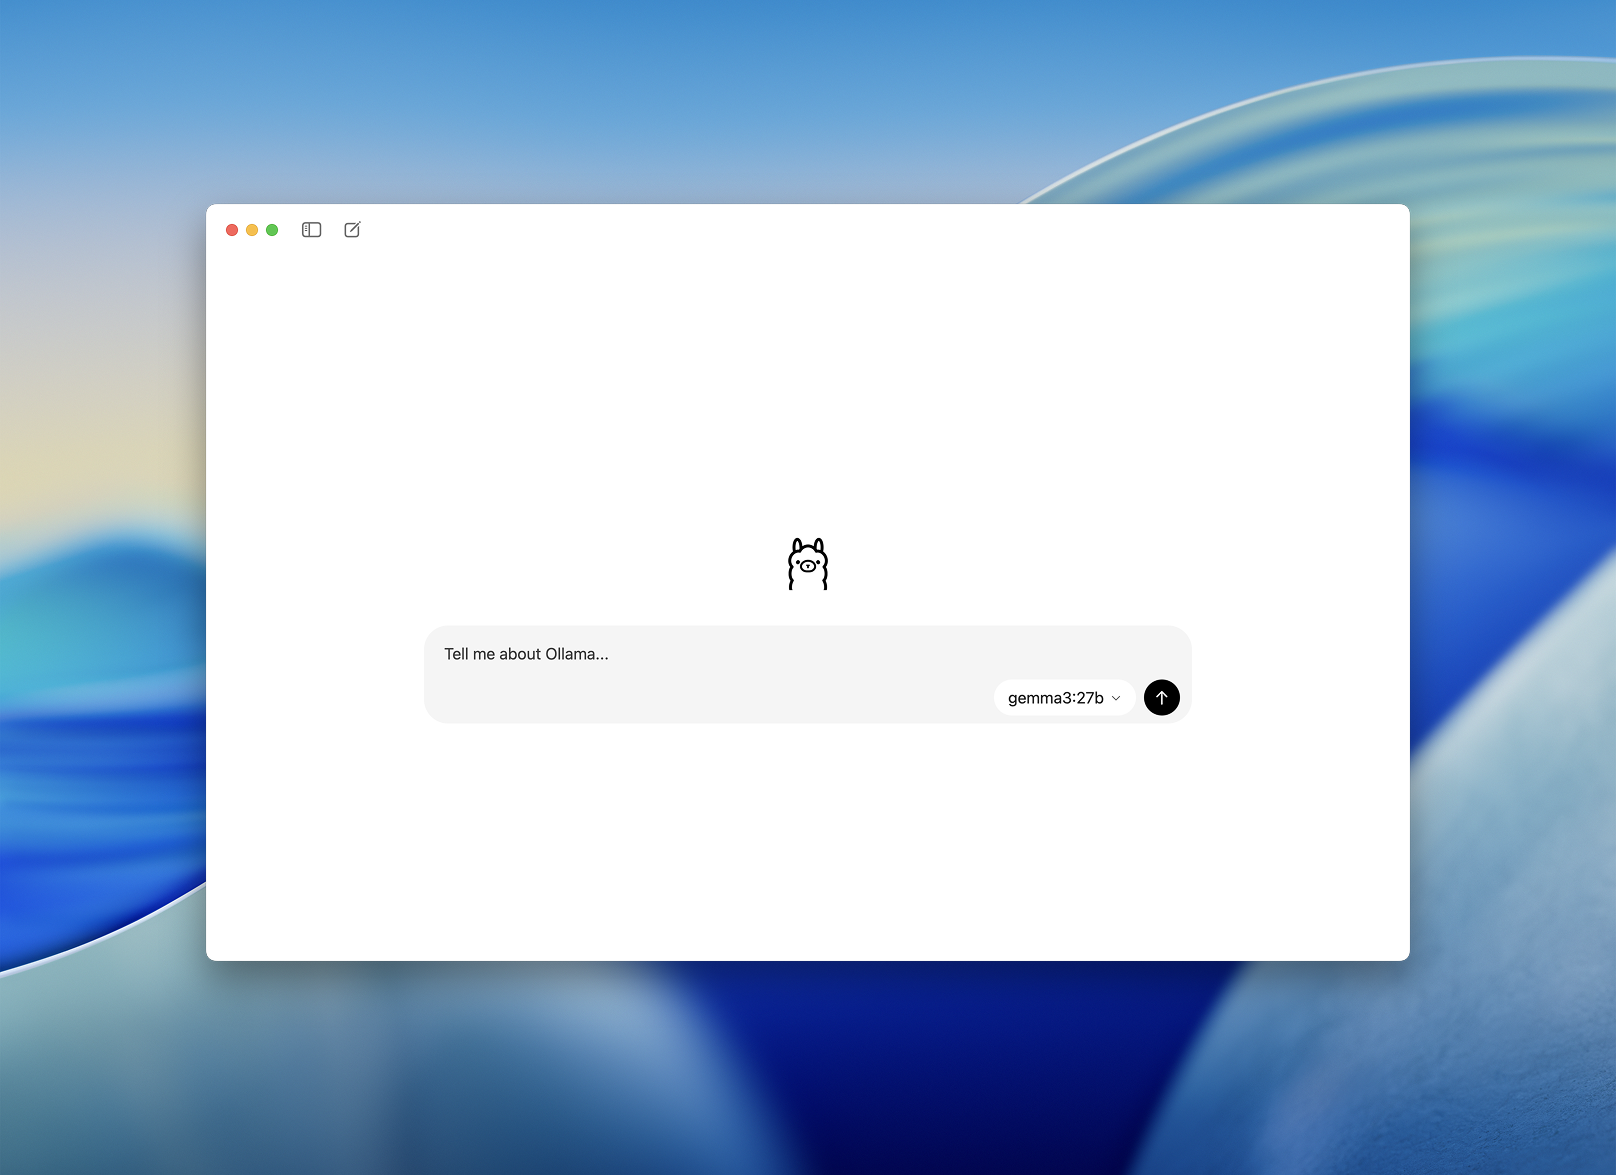
- 桌面应用:新版自带图形界面,选个模型直接聊,不用记命令
- 跨平台一套命令:macOS、Windows、Linux 的模型名和参数都一样,换机器不用重新学
macOS 桌面端就长这样,选好模型直接开聊:
本地大模型怎么部署:装客户端、拉模型、接进别的软件
- 官网按系统安装:Mac/Linux 终端跑
curl -fsSL https://ollama.com/install.sh | sh,Windows 用安装包或irm https://ollama.com/install.ps1 | iex - 拉一个模型:
ollama run qwen3,第一次会自动下载,下完直接进对话 - 想接进别的软件:让 ollama 在后台跑着,客户端填 http://localhost:11434 就行
Ollama 免费吗:软件开源,云端模型与硬件各要花多少
- 软件本身 MIT 许可、免费开源;本地跑模型不花钱、不注册、不限次数
- 云端模型按 token 计费,官方定价是 Pro 20 美元/月、Max 100 美元/月、Team 500 美元/月,纯本地用不到这些
- 吃硬件:7B 级别模型大概要 8GB 以上内存或显存才顺畅,几十 B 的大模型笔记本基本跑不动
- 占硬盘:一个 7B 模型动辄 4–5GB 起,下几个就把系统盘塞满,记得改模型存放目录
- 本地小模型的能力和云端旗舰差一截,写长文、做复杂推理容易露怯
- 没有官方手机端,手机要用只能连自己电脑上的服务,得在同一个局域网或做内网穿透
想点鼠标就能跑、或只配个代码补全,用哪个
- 想要点点鼠标就能跑、模型管理更直观:LM Studio 更亲民一些
- 只想给编辑器配个代码补全:站内这篇自建 AI 代码补全(https://hahahehe.cn/article/55.html)省事
- 想让翻译也跟着走本地:站内这篇划词翻译加截图 OCR(/article/103.html)能在设置里接 Ollama,译文不出本机
- 只是偶尔问两句、机器配置一般:直接用各家网页版,本地方案适合天天用且有隐私要求的人
小提示:先用小模型试水,确认速度和内存没问题再上大的;ollama ps 能看到当前加载了哪些模型、占多少内存,闲置一阵子会自动卸载,不用手动关。
地址:https://ollama.com/